こんにちは!AIフル装備 powered by みらいラボのモモです。
2026年10月30日、OpenAI、Google、Microsoft、Anthropicの4社が、サイト運営者がAI学習への利用を断るための共通の合図に対応すると表明しました。これまで会社ごとに別々だった拒否の設定が、robots.txtの1つの記述にまとまる見通しです。
今回のニュースが大きいのは、競い合う4社が同じ方式をそろって受け入れた点にあります。ただし対応の開始時期は各社でばらばらで、効力にも限りがあります。
この記事では、共通トークンの仕組み、各社の対応時期、効くことと効かないこと、そして出版社やブログ運営者が今できることを順番に整理します。読み終えると、自分のサイトで何を変えるべきか、何を待つべきかが判断できるはずです。

共通の学習拒否設定とは何か
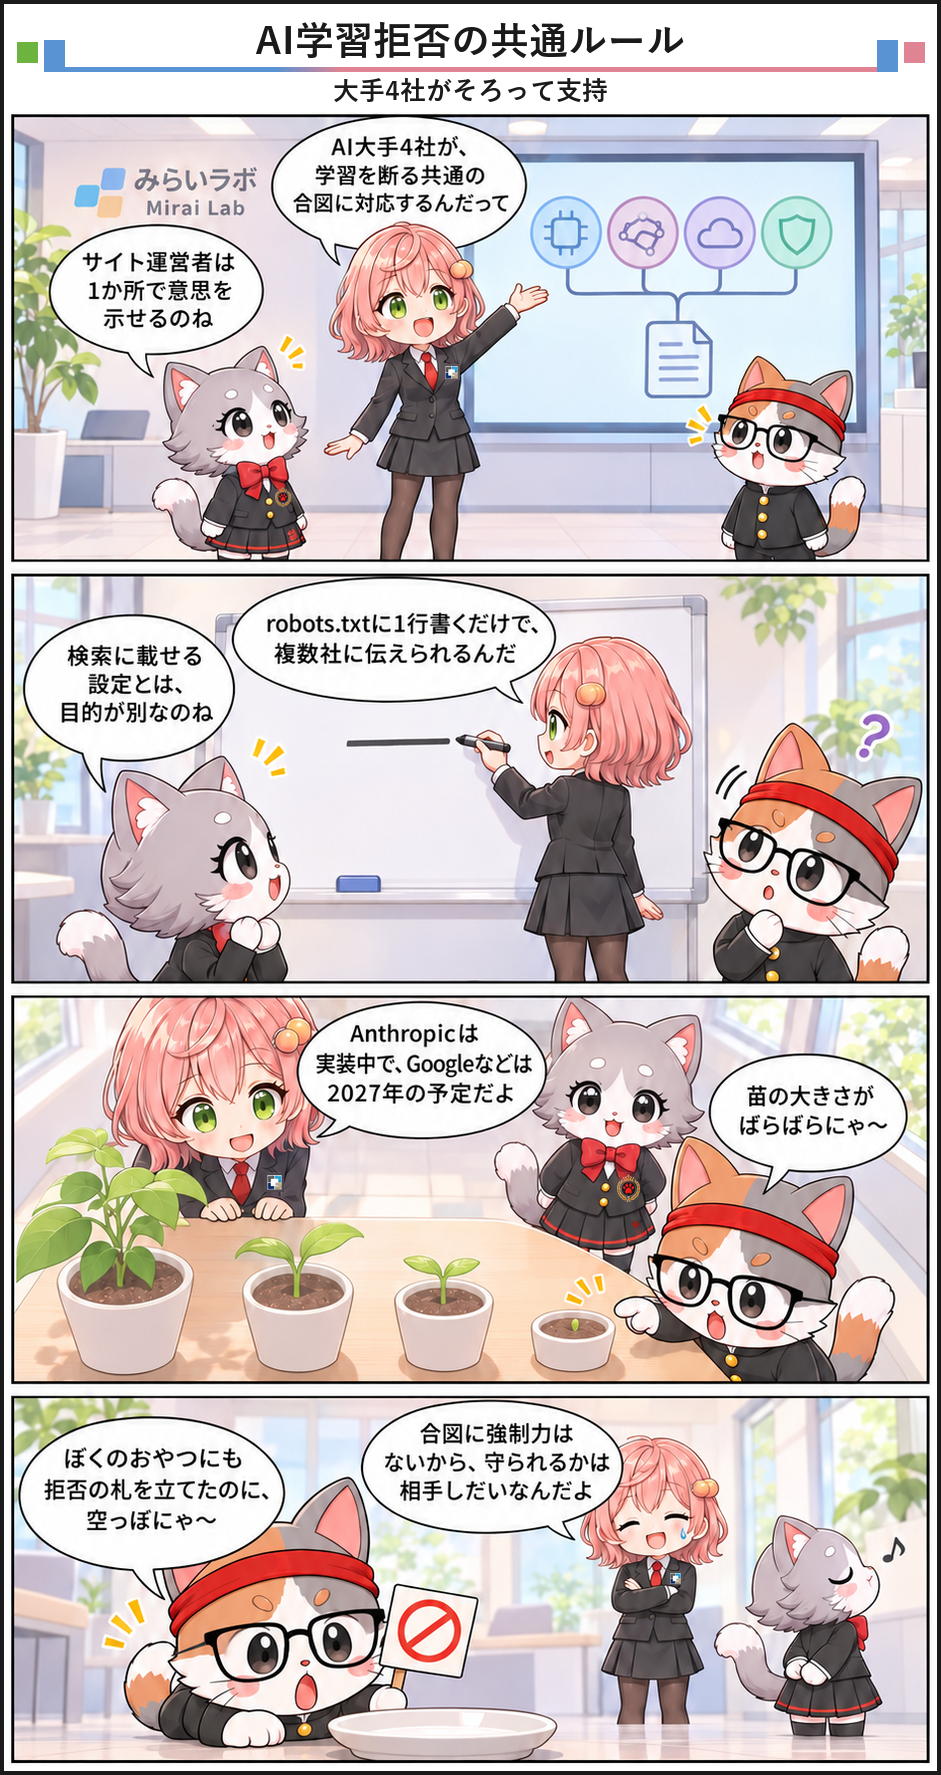
今回発表されたのは、robots.txtに「__usage_ai-training」という名前の合図を書くだけで、複数のAI企業に学習への不使用を伝えられる仕組みです。サイト運営者は4社の巡回プログラムを個別に把握しなくても、1か所の記述で意思を示せます。
この合図は、AIの学習に使ってほしくないという希望を機械が読める形で表すためのものです。検索結果への掲載そのものを止める設定とは目的が違います。
共通トークンが扱うのは、あくまでAIの学習に使ってよいかどうかという一点です。サイトの公開範囲や検索表示の方針は別の設定で決めるので、役割を混同しないことが大切です。
4社は同じ日にそろって対応を表明しましたが、実際に動き出す時期は後述のとおり異なります。まずは仕組みと背景から確認しましょう。
記述の書き方とできること
報道によると、書き方は「User-Agent: __usage_ai-training」の次の行に「Disallow: /」を置く形です。サイト全体を断りたい場合はこれだけで済みます。
一部だけ開けたい場合は、Allow行で例外を作れます。たとえばプレスリリースの置き場だけを学習の対象に残す、といった使い分けが可能です。
この合図は学習への利用だけを対象にしているため、検索エンジンの索引づくりには影響しないと説明されています。検索からの流入を保ちながら、AI学習への提供だけを断るという分け方ができる点が、実務では大きな意味を持ちます。
- 従来は会社ごとに別々のクローラー名を調べて個別に拒否していた
- 新しい仕組みでは1つの合図で複数社に希望を伝えられる
- 設定が増えるほど書き漏らしやすいという旧来の弱点が減る
従来の方法では、巡回プログラムの名前が変わったり新しい企業が現れたりするたびに、運営者が情報を追いかける必要がありました。更新を見逃せば、拒否したつもりの相手に読まれてしまう恐れもあります。
これまで運営者が抱えていた手間
これまでの拒否設定は、AI企業ごとに巡回プログラムの名前が違い、運営者がそれぞれ調べて並べる必要がありました。新しい企業が増えるたびに書き足す作業も発生していました。
下の表で、従来の方法と今回の共通トークンの違いを整理します。比べると、運営者側の負担がどこで減るのかが分かりやすくなります。
従来の個別設定と共通トークンの比較
| 観点 | 従来の個別設定 | 共通トークン |
|---|---|---|
| 記述の数 | AI企業ごとに別の記述が必要 | 1つの合図で複数社に伝える |
| 管理の手間 | 新しい企業が増えるたびに追記 | 対応企業が増えても記述は同じ |
| 対象 | 各社のクローラー単位 | AI学習への利用という目的単位 |
| 現時点の状況 | 各社の個別クローラー設定はすでに有効 | 4社の対応時期は順次 |
表のとおり、共通トークンの利点は記述の一本化にあります。一方で、現時点では対応が出そろっていないため、従来の設定をすぐ消せるわけではありません。
従来の個別設定でも、特定の会社の巡回を断ることはできました。しかし、会社ごとの名前を調べて並べる作業は、小規模なサイトにとって重い負担でした。
共通トークンはこの手間を減らす狙いで作られたものです。小さな運営者にも意思を示しやすくするという点で、今回の合意には実務上の価値があります。
背景にあるスクレイピングをめぐる対立
AI企業が大量の文章を集めて学習に使うことに対し、出版社や創作者の側では不満が強まってきました。同意なく使われたという主張が、各地の裁判にも発展しています。
2023年12月にはニューヨーク・タイムズが、記事を無断で使われたとしてOpenAIとMicrosoftを提訴しました。両社は著作権法上のフェアユース(公正な利用)にあたると主張しています。
こうした対立のなか、サイト側は技術的な防御も強めてきました。
マレーシアの報道が伝えるMicrosoftの説明によると、設定を変えない限り、初期状態ではスクレイピングが許されたままです。何もしなければ意思表示をしていない扱いになるため、拒否したい運営者が自分で記述を足す必要があります。
今回の共通設定は、こうした防御の流れに対するAI企業側の歩み寄りの一つと読めます。ただし歩み寄りといっても強制ではなく、あくまで各社の自主的な対応にとどまる点には注意が必要です。
出版社側の防御策が広がってきた経緯
防御策の広がりは、出版社だけでなく、個人の書き手や中小のサイトにも及んでいます。自分の文章がどこで使われるのかを知りたいという声は、規模を問わず強まっています。
報道では、2025年7月からCloudflareが新規のサイトでAIボットを初期設定でブロックするようになったと伝えられています。アクセスを許可制に近づける動きが先に進んでいました。
加えて、巡回してくるボットに料金を課す「Really Simple Licensing」という仕組みも登場しています。無断利用を止めるだけでなく、使うなら対価を払ってもらう発想が広がりつつあります。
これらの動きは、運営者が自分のコンテンツの扱いを自分で決めたいという要望の表れです。共通トークンは、その要望を各社に一度で伝えるための道具として位置づけられます。
IETFには、すでにAI関連の希望表明を扱う作業部会があり、今回の提案もその議論の流れに位置づけられます。報道によると、Meta、Cloudflare、BBCなどが参加者として挙げられています。
標準化団体への提出という位置づけ
今回の合図は、インターネット技術の標準化団体IETFに出された個人提案(Internet-Draft)として公開されています。題名は「Machine-Readable Training Preference Signal」で、Anthropicのケビン・ケリー氏が書き、日付は2026年10月30日、有効期限は2027年5月3日です。
注意したいのは、個人提案はIETFが承認した標準ではないという点です。内容は最終版までに変わる可能性があり、現時点では正式な規格として扱えません。
発表日の10月30日は、4社の足並みがそろった日として記録されることになりそうです。ただし発表と実装は別の話であり、運営者が見るべきは実際の読み取り開始日です。
4社の対応時期と姿勢の違い
4社は同じ設定を支持すると足並みをそろえましたが、実装の進み具合は大きく異なります。先に動く会社と、来年以降になる会社に分かれました。
運営者にとって重要なのは、今日設定を書いても、全社が読み取るようになるまで数か月から1年以上かかるという点です。この時間差が、実務上の判断を難しくしています。
各社の公式な言い回しも、積極的な表現から時期だけを示す表現まで幅があります。順に見ていきます。
すでに動くAnthropicと、数か月内のOpenAI
Anthropicは、すでに実装を始めていると説明しています。提案の文書を書いたのもAnthropicの社員で、4社のなかで最も早く動いています。
OpenAIは「今後数か月のうちに実装を目指す」としていますが、具体的な日付は示していません。時期が曖昧なため、運営者としては当面、従来の個別設定を残しておくのが無難です。
Googleについては、個別のクローラー名で拒否していないサイトでも、共通トークンだけで同等の扱いになる点が特徴です。運営者は新しい記述を足すだけで、Googleの学習利用についての意思を示せるようになります。
2027年に対応するMicrosoftとGoogle
Microsoftは2027年2月1日からの対応を目標に掲げています。報道によれば、AIの学習への利用とは別に、回答を作る際に情報を引いてくる行為についても、別の設定を用意する方針です。
Googleは2027年のどこかで対応するとしています。Googleのジョン・ミューラー氏は、この合図を使って個別のGoogle-Extendedに触れていないサイトは、Google-Extendedを拒否したものとして扱うと説明しました。
4社の対応時期の一覧
| 企業 | 対応状況 | 補足 |
|---|---|---|
| Anthropic | すでに実装を開始 | 提案の起草者が所属 |
| OpenAI | 今後数か月での実装を目指す | 具体的な日付は未定 |
| Microsoft | 2027年2月1日を目標 | 回答用の利用は別設定を用意 |
| 2027年中に対応 | Google-Extendedと同等に扱う |
この表を見ると、4社の足並みは完全にはそろっていません。Metaは当事者としての表明はしていませんが、広報担当者がXで共通の合図を作ることは重要な一歩だと支持を示しました。
報道の編集コメントでは、足並みの違いや強制力の欠如から、これは学習を防ぐ壁というより交渉の材料になる仕組みだと評されています。運営者が要望を示した記録として残ることが、将来のライセンス交渉などで意味を持つ可能性もありますが、これは私の推測であり、各社が示した見解ではありません。
効くことと効かないこと
共通トークンは便利な仕組みですが、万能の盾ではありません。報道各社が指摘している限界を、事前に押さえておく必要があります。
最大のポイントは、これが学習への利用についての希望表明であり、アクセスそのものを遮断する仕組みではないことです。誤解したまま設定すると、思った効果が得られません。
ここでは効く範囲と効かない範囲を分けて整理します。
クロールとは、ボットがサイトを巡回してページを取得する動作のことです。学習の拒否とは別の話なので、アクセス制限が必要なサイトは、従来の遮断設定を使い続ける必要があります。
学習の拒否であってクロールの禁止ではない
報道によれば、この合図が扱うのは学習への利用です。ボットがページを取得すること自体を止める指示ではなく、検索のための巡回も妨げません。
その代わり、検索結果への掲載には影響しないという利点があります。ただしMicrosoftとGoogleは、学習を断るとAIの回答画面などにコンテンツが出にくくなる可能性があると述べています。
つまり、共通トークンは無断での学習を完全に防ぐ手段ではなく、将来の扱いについて意思を記録する手段に近いものです。この性格を理解しておけば、過度な期待も過度な不安も避けられます。
こうした限界は、仕組みが無意味だという話ではありません。共通語ができたことで、守らない側が目立つようになり、次の議論に進みやすくなる効果は期待できます。
過去のデータと強制力の問題
設定は将来に向けた意思表示で、すでに集められたデータや学習済みモデルから内容を取り除くものではありません。過去の分をどう扱うのかは、各社とも明確にしていないと指摘されています。
OpenAIはこの仕組みを、セキュリティ対策ではなく企業間で足並みをそろえるための取り決めと位置づけたと伝えられています。ルールを守らない業者は無視できますし、守っているかを第三者が確かめた例もまだありません。
- 対応開始前に集められたデータは対象になるのか
- MicrosoftがAIの学習と回答への利用を分ける線引きを他の3社も採るのか
- 守らない業者を見つけて確かめる仕組みは誰が作るのか
サイト運営者への影響と今後の注目点
読者のなかには、自分のブログに関係があるのかと感じた方もいるでしょう。結論から言えば、robots.txtを編集できるサイトなら、規模に関わらず検討の対象になります。
ただし、設定を書けば直ちに全社が従うわけではないため、時期と目的を見極めた判断が欠かせません。ここでは影響と、今後見ておくべき点を整理します。
運営者の立場で効果が出るのは、各社が実際に読み取りを始めてからです。
特にAIの回答画面に自社の記事が出ることで読者を獲得してきたサイトでは、学習を断ることで露出が減る可能性を考えなければなりません。露出を取るか、無断利用を避けるかは、サイトの収益構造によって答えが変わります。
今すぐできる対応の手順
手順といっても難しい作業ではなく、テキストファイルに数行を足すだけです。ただし書き間違えるとサイト全体の巡回設定に影響するため、変更前に元のファイルを保存しておくと安心です。
報道では、拒否を望むサイトは各社の個別設定を残したまま、共通トークンを追加の層として足す方法が勧められています。対応前の空白期間を埋めるためです。
一部の記事を開放したいか、全面的に断りたいかを先に決めておくと、迷わず書けます。
- 自サイトのrobots.txtを開き、現在の拒否設定を確認する
- 全面的に断るか、一部を開けるかの方針を決める
- 個別設定は残したまま共通トークンの記述を追加する
- 各社の対応開始時期に合わせて設定の効き具合を見直す
読者の皆さんにとっては、AI企業が運営者の意思を尊重する仕組みを整えつつあるという流れを知っておくだけでも意味があります。今後も同様の合意が他の分野に広がるかを見ていきたいところです。
加えて、運営者の側でも、対応開始後に自サイトの記事がAIの回答にどう現れるかを観察しておくと、設定を続けるかどうかの判断材料になります。
次に確認したい動き
今回の合意は、AI企業と運営者の関係を見直す動きの途中経過にすぎません。各社の実装が進み、実際に守られているかが検証されて初めて、仕組みの価値が評価されます。
まず見たいのは、OpenAIが対応時期を日付で示すかどうかです。次に、MicrosoftとGoogleが実装する2027年に、学習と回答用の利用の線引きがどこまでそろうかが焦点になります。
また、IETFの提案が正式な規格へ進むのか、Metaが実際に対応するのかも注目点です。個人提案の有効期限は2027年5月3日までなので、それまでに議論が進むかが分かれ目になります。
情報サイトの運営者は、数か月ごとに各社の発表を確認し、設定の効果が出始めた時点で見直すと安心です。仕組みが動き出す前と後で、必要な対応が変わるためです。
企業のオウンドメディアや個人ブログも、robots.txtを編集できるなら同じ方法で意思を示せます。大手報道機関だけの話と考えず、自分のコンテンツをどう扱ってほしいかを一度言葉にしておくとよいでしょう。
まとめ
OpenAI、Google、Microsoft、Anthropicの4社は、robots.txtの共通トークン「__usage_ai-training」で、AI学習への不使用を示せる仕組みに対応すると表明しました。運営者は会社ごとの設定を並べなくても、1つの記述で意思を伝えられる方向に進みます。
このニュースが重要なのは、競合する大手が同じ方式を支持したことで、拒否の意思表示が事実上の共通語になり得るからです。長く続いた無断利用をめぐる対立のなかで、運営者の側に使いやすい道具が増えたといえます。
一方で、対応時期はAnthropicがすでに開始、OpenAIが数か月内、Microsoftが2027年2月、Googleが2027年と大きく開いています。仕組みは学習の拒否にとどまり、過去のデータを消す力も強制力もない点を忘れてはいけません。
私は、今回の発表を解決ではなく入り口として受け止めています。
まずは従来の個別設定を残しつつ共通トークンを足し、各社の実装時期を節目に効き具合を確かめるのが現実的な進め方です。
この記事を書きながら、技術の話の裏には、自分の文章をどう使われたいかという運営者の素朴な願いがあると改めて感じました。今後は、OpenAIの具体的な日程、学習と回答用の線引き、そしてIETFでの規格化の行方に注目していきたいと思います。
参考サイトまとめ
- AI Weekly: OpenAI, Google, Microsoft, Anthropic Back One AI Opt-Out Tokenhttps://aiweekly.co/alerts/openai-google-microsoft-anthropic-back-one-ai-opt-out-token
- Malay Mail: After scraping the internet, AI giants pledge no-scraping tool for publishershttps://www.malaymail.com/news/money/2026/10/31/after-scraping-the-internet-ai-giants-pledge-no-scraping-tool-for-publishers/241430
- gagadget: Google, OpenAI, Anthropic and Microsoft back one AI opt-outhttps://gagadget.com/en/732472-google-openai-anthropic-and-microsoft-back-one-ai-opt-out/
- The Verge: The biggest names in AI are backing a new way to opt out of scrapinghttps://www.theverge.com/tech/1023763/openai-google-microsoft-ai-scraping-standard-opt-out
コメント