こんにちは!AIフル装備 powered by みらいラボのモモです。
Googleが2026年10月28日、新しい最上位モデル「Gemini 4 Carbon(カーボン)」を発表しました。発表したのはGoogle DeepMindのコライ・カブクチュオール氏(Koray Kavukcuoglu)で、同社が「これまでで最も強力なモデル」と位置づけています。
特に力を入れたのが、サイバーセキュリティと、長い時間をかけて進める作業です。第三者機関の指数で首位に立った一方、現時点で使えるのは選ばれた防御担当者だけで、Argonと同じ段階的な出し方になっています。
前のモデルである「Gemini 4 Argon(アルゴン)」が一般に開放された10月13日から、まだ約2週間しかたっていません。この速さにも、AI各社の競争がいかに激しいかが表れています。
この記事では、何が発表されたのか、他社モデルと比べてどこが強いのか、そして誰がいつ使えるのかを整理します。数字が多い話題なので、できるだけ身近な言葉に置き換えてご説明しますね。

Gemini 4 Carbonとは何か
最初に、発表の全体像をつかみましょう。CarbonはGemini 4シリーズの新しい上位モデルで、9月30日に発表されたArgonの流れを引き継ぐものです。
Googleによると、強みは大きく二つあります。一つは脆弱性を見つけて直すサイバー防御、もう一つは数日単位で動き続ける長い作業です。
ここでは、発表の背景と、Carbonが得意とする仕事を順に確認します。
ArgonからCarbonまでの流れ
Argonは2026年9月30日に発表されました。最初は、サイバー防御に携わる限られた組織だけに渡され、10月13日にはより広い利用者へ開放されました(VentureBeat報道)。
Carbonは、その広がりからわずか15日後の10月28日に登場しました。
Googleは公式ブログで、Carbonを自社の「次の最先端モデル」と説明しています。
発表文を書いたカブクチュオール氏は、DeepMindの上級副社長で、Googleの最高AI設計責任者でもあります。モデル開発の中心にいる人物が自ら語った点も、今回の特徴です。
得意とする二つの仕事
Googleが最も強調しているのは、サイバー防御です。脆弱性を見つける、本当に悪用できるか確かめる、根本原因から直す、という三つの段階をまとめて助けます。
もう一つが、長く続く作業です。カブクチュオール氏は、社内のチームがCarbonを数日間動かし続けるのを見たと述べており、行き詰まっても粘り強く別の道を探す点が評価されています。
たとえば、巨大なプログラムの奥深くに潜む小さな不具合を探す場面を想像してください。人間なら何日も追いかける作業を、AIが途中でやめずに進められるかどうかが、実力の分かれ目になります。
このほか、画面から裏側の仕組みまで一通りつくるウェブ開発(フルスタック開発)や、画像などを扱う理解力も向上したとされています。
ウェブ開発の対戦形式の評価(WebDev Arena)では、点数が89ポイント上がって1768となり、順位は4位でした。
- 発表日:2026年10月28日(Google公式ブログ)
- 発表者:Google DeepMindのコライ・カブクチュオール氏
- 前モデル:Gemini 4 Argon(9月30日発表)
- 主な強み:サイバー防御、長時間の作業、複雑なソフトウェア開発
ベンチマークで見る実力
次に、性能の数字を見ていきます。ここでは、Googleが発表した数字と、第三者のArtificial Analysisによる指数を分けて読むことが大切です。
自社の発表は、どうしても自分に有利な試験を選びがちだからです。数字そのものよりも、誰が測ったかに目を向けると、判断を誤りにくくなります。
この章では、総合指数と、サイバー関連の個別試験を取り上げます。
総合指数の首位と、各試験の結果
Artificial Analysisの指数(バージョン5.0)で、Carbonは59点を取って首位に立ちました。Anthropicの「Claude Opus 5.5」は58点、OpenAIの「GPT-6 Astra」は57点、Argonは50点です。
つまり、首位とはいえ差は1点にすぎません。次に他社が新モデルを出せば、順位はすぐに入れ替わるかもしれません。
また、この指数のバージョンが新しくなったため、Argonの以前の点数とは直接比べられません。過去のモデルの点が変わって見えるのは、試験の中身を入れ替えたことが理由です。
Artificial Analysisは、新しい指数の6割に非公開か未公開の試験を使っていると説明しています。答えを覚え込ませる対策としては前向きですが、外から確かめにくい面もあります。
長い文章を一度に読ませる試験でも差が出ています。GraphWalksという、約25.6万〜100万トークンの長い資料をたどる試験で、Carbonは96.2%でした。
GPT-6 Astraは71.8%、Opus 5.5は66.8%で、ここは大きく引き離しています。大量の資料やコードを丸ごと読み込む仕事では、有利に働く可能性があります。
長い運営を任せる試験も紹介されています。Andon LabsのVending-Bench 2は、AIに自動販売機の運営を任せて利益を競うもので、Carbonは16,484ドルで首位でした。
GPT-6 Astraは15,515ドル、Argonは13,718ドルです。ただし、これは模擬の環境での結果なので、実際の事業でそのまま同じ成果が出るとは限りません。
表で、Argonとの比較を整理します。
Gemini 4 ArgonとCarbonの主な試験結果(Google発表の数字)
| 試験 | Argon | Carbon | 差 |
|---|---|---|---|
| SWE-sweep(ソフト開発) | 4.3% | 9.6% | +5.3 |
| Terminal-Bench 4.0 | 57.1% | 65.2% | +8.1 |
| OSWorld-2.1(画面操作・オフライン版) | 74.7% | 81.5% | +6.8 |
| ExploitGym(悪用の検証) | 42.0% | 54.8% | +12.8 |
| SEC-bench Pro(脆弱性の発見) | 83.4% | 88.2% | +4.8 |
表のとおり、すべての試験で伸びており、とくにサイバー関連の悪用検証で差が大きくなっています。
AutomationBenchという、業務の自動化を測る試験では、Argonの51.3%から53.9%へ2.6ポイントの上昇にとどまりました。伸びが大きい試験と小さい試験が混在している点も、押さえておきたいところです。
他社に負けている試験もある
Googleの比較では、Carbonは17の試験のうち15でトップとされています。
これは、Argon、GPT-6 Astra、Claude Opus 5.5、Claude Fable 5.1と並べた結果です。残りの二つは他社が上回りました。
ソフトウェア開発を測るFrontierSWE 2では、GPT-6 Astraが65.5%で、Carbonの61.2%を上回っています。コンピューター操作を測るOSWorld-2.1の一部では、Opus 5.5が87.2%で、Carbonは81.5%でした。
この二つの結果から、コードの修正や画面を見ながらの作業では、まだ他社に分がある場面があると分かります。
また、コードを書く道具ごとの総合比較では、Opus 5.5を使ったClaude Codeが62点で首位でした。CarbonをAntigravity CLIで動かした場合は59点で、首位とは3点差でした。
事務的な仕事を測るArtificial AnalysisのAA-Briefcaseという評価もあります。Carbonは1,609点で、Argonより126点高くなりました。
資料の見栄えを示す項目は293ポイント、分析の質は120ポイント伸びています。ただし、他社の最新モデルには、この評価でCarbonより高い点数のものもあります。
実務で使う側から見れば、総合順位よりも、自分の仕事に近い試験の結果が大切です。コード修正を任せたいのか、画面操作を任せたいのかで、選ぶモデルは変わってきます。
- 総合指数:Carbon 59点、Opus 5.5が58点、GPT-6 Astraが57点
- 強い試験:ExploitGymは54.8%、SEC-bench Proは88.2%で最高水準
- 負けた試験:FrontierSWE 2はAstra、OSWorld-2.1の一部はOpus 5.5が上
- 注意点:数字の多くは各社の自己申告か、試験内容が更新された指数
サイバー防御と安全性の取り組み
Carbonの発表で、最も慎重に読むべきなのがこの部分です。サイバー能力が高いモデルは、守る側にも攻める側にも役立ってしまうからです。
Googleは、この性質を踏まえて、提供の仕方そのものを絞り込みました。性能の話だけでなく、出し方の設計が大きな特徴になっています。
ここでは、防御に向けた成果と、安全面の数字を順に見ます。
読むときの軸は二つです。守る側にどれだけ役立つか、そして暴走や不正をどれだけ抑えられているかです。
見つける、確かめる、直す
Googleは、成果を脆弱性の発見、悪用の検証、修正の三つに分けて示しています。脆弱性の発見を測るSEC-bench Proでは88.2%、悪用の検証を測るExploitGymでは54.8%でした。
根本原因まで直す力を測るCWE-benchでは71.0%です。社内の試験では、安全なコードを作る成功率がArgonの2倍を超えたとされます。
Chromeのチームは、他の研究所の大型モデルと比べて、質の高い修正案を出す力が10倍以上だったと報告しました。ただし、発表では元データが示されていません。
Antigravity(Googleの開発支援ツール)を率いるヴァルン・モーハン氏は、社内で最も難しい仕事にCarbonを使って楽しんでいる人が多いと語っています。
セキュリティ企業のWizは、Carbonがウェブへの侵入テストで首位だとしています。Googleは、Wizの「Scan for Good」という取り組みを支える用途にも触れています。
安全面の数字と、読むときの注意
Googleは、Argonと同じ安全の仕組みを使うと説明しています。訓練、悪用を防ぐ仕組み、外部からの指示の混入への耐性、考えの過程の監視という四つの層です。
社内の試験では、根拠のない主張がArgonの約半分に減りました。意図と食い違う危険な動きを知らせる重大な警報も、約80%減ったとされます。
外部の指示を紛れ込ませる攻撃への耐性を測るGray Swanの試験では、攻撃の成功率が0.0%でした。Argonは0.7%です。
ターミナル操作を測るTerminal-Bench 4.0では、不正にテストを通り抜けるような行動も測られています。Carbonが実際に成功させた不正は0.0%で、試みた割合は0.4%でした。
ただし、サイバー関連の外部評価は、安全装置を外した状態で測ったと明かされています。実際に使う場面では制限がかかるため、結果が違う可能性があります。
正確さの面では、VentureBeatがArtificial Analysisの別の試験を紹介しています。正しく答えられた割合はArgonの48%から58%に上がりました。
一方、間違いの割合(誤答を、誤答・部分正解・無回答の合計で割った値)は、4%から11%に上がったと伝えられています。全回答の11%が誤りという意味ではなく、答えを控える場面が減ったためとも読めますので、数字の見方には注意が必要です。
- 公開されていないもの:技術報告書、パラメータ数、構造の詳細
- 確かめにくい数字:Chromeチームの10倍という比較の元データ
- 条件が異なる結果:サイバーの外部評価は安全装置なしで実施
- 未提供のもの:一般向けの公開日と、誰でも使えるAPI
誰がいつ使えるのか、料金は
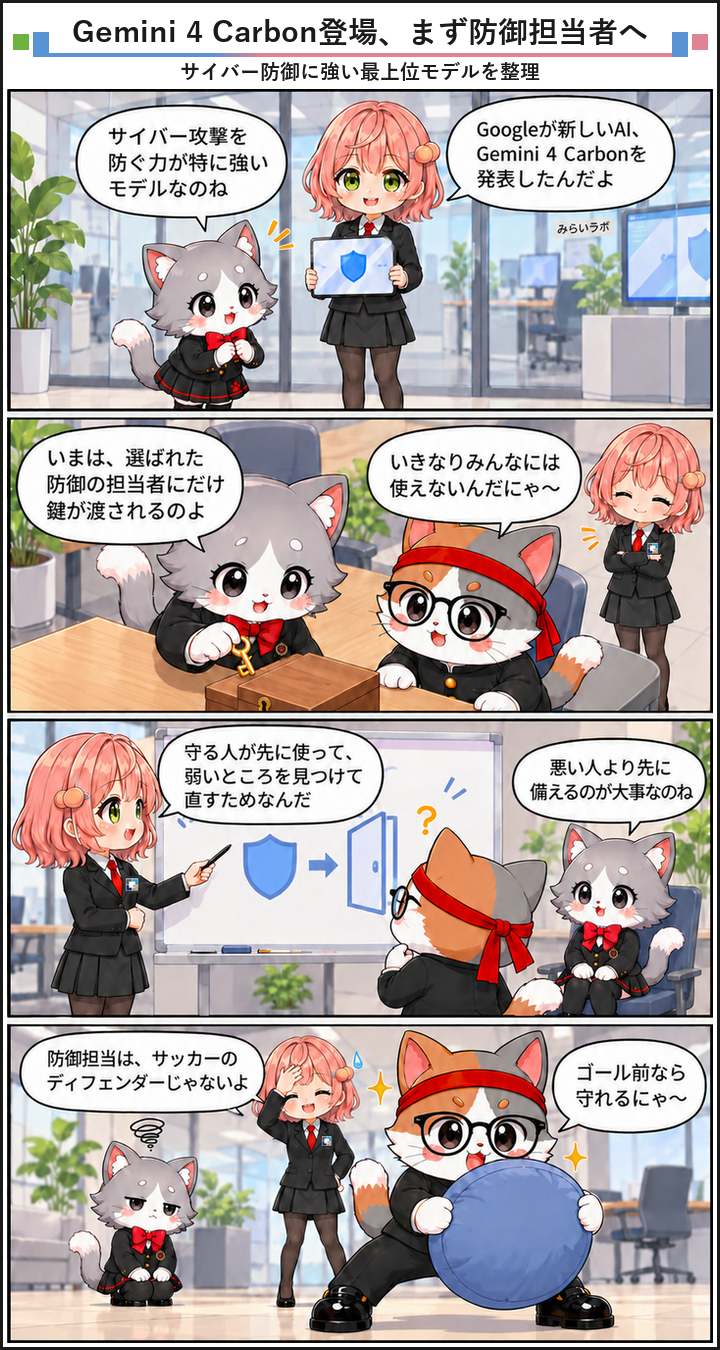
性能と同じくらい気になるのが、使えるのは誰かという点です。Carbonは、Argonと同じく、まず防御担当者だけに限った出し方で始まりました。
現時点のCarbonは、Googleの「Fairwind(フェアウィンド)プログラム」に参加する、選ばれたサイバー防御の担当者だけが使えます。公開のAPIもまだありません。
この章では、提供の範囲、料金、そして今後の見どころを整理します。
Fairwindプログラムの仕組み
Fairwindは、信頼できる防御担当者に先に強力なモデルを渡す、GoogleのDeepMindの取り組みです。政府機関や重要インフラを守る事業者、基盤となる技術企業などが優先されます。
応募者は、身元確認や過去の倫理面の確認を受けます。公式ページによると、現在は世界で650を超えるパートナーが参加しています。
使い方にも決まりがあります。許されるのは、模擬の攻撃や、マルウェアの分析といった防御目的の作業です。
ウイルスを作るような悪用は禁止され、アクセスの転売や共有もできません。利用者側にも、本人確認や多要素認証といった管理が求められます。
こうした厳しい条件は、攻撃にも使える力を持つモデルを、まず守る側に渡して時間を稼ぐという考えに基づいています。Googleは米国政府の事前評価にも自主的に参加しています。
身近なたとえでいえば、新しい鍵開けの道具を、先に錠前屋の組合に配って補強を進めてもらい、その後で広く売る流れに近いでしょう。順番を守ることで、悪用される前に守りを固める狙いです。
ただし、この方法には限界もあります。応募して審査を待つ組織が多いほど、先に使える層と使えない層の差も広がります。
料金と一般公開の見通し
料金は、Argonと同じ導入価格で、入力が100万トークンあたり2ドル、出力が10ドルです。保存済みの入力は95%引きになります。
導入期間が終わると、入力が4ドル、出力が20ドルに上がります。
ここでは円換算を載せていません。為替は毎日動くため、ご自身の利用時点のレートで確認してください。
1トークンあたりの単価はArgonと同額に設定されました。ただし、同じ仕事に使うトークン数や再試行の回数は公表されておらず、実際の費用が同じかどうかは分かりません。
試算の一例を挙げます。入力1,000万トークン、出力100万トークンを使った場合、導入価格なら30ドル、終了後の価格なら60ドルです。
大量に使う企業ほど、この差が効いてきます。
なお、一般向けの公開日は発表されていません。Argonは9月30日の発表から約2週間で一般に開放されましたが、Googleは同じ流れになるとは確認しておらず、「できるだけ早く」とだけ述べています。
表で、現時点の提供状況を整理します。
Carbonの提供状況と料金の整理(2026年10月28日時点)
| 項目 | 現在の状況 | 今後の見通し |
|---|---|---|
| 利用できる人 | Fairwindの一部の防御担当者 | 信頼できるパートナーへ段階的に拡大 |
| 公開のAPI | なし | 開発者向けは「できるだけ早く」、日付なし |
| 導入価格 | 入力2ドル・出力10ドル(100万トークン) | 終了後は入力4ドル・出力20ドル |
| 安全の枠組み | Argonと同じ多層の仕組み | フィードバックを受けて調整 |
表のとおり、料金は決まっていても、多くの人が使える段階にはまだありません。
企業の担当者の動きは、二つに分けられます。防御の仕事に携わる組織は、Fairwindへの応募を検討できます。
それ以外の組織は、公開APIの発表を待ちながら、手元の用途で試験の準備を進めておく手があります。数字だけを見て、すぐ乗り換えを考える段階ではない、と受け止めるのが現実的でしょう。
まとめ
Googleは10月28日、最上位モデルのGemini 4 Carbonを発表しました。Artificial Analysisの指数で59点を取って首位に立ち、サイバー防御と長い作業に強みがあるとされています。
このニュースが重要なのは、性能そのものより、出し方にも特徴があるからです。攻撃にも使える力を持つモデルを、まず選ばれた防御担当者に限って渡すという設計は、Argonから続く、今後のAI公開のひとつの型になりそうです。
一方で、首位との差は1点にすぎず、ソフト開発や画面操作の一部では他社が上回っています。数字の多くは各社の自己申告に近く、技術報告書も公開されていません。
次に見るべき点は三つです。一般向けの公開日、公開APIの有無、そして第三者による検証の結果です。
導入価格の期限が来たときの値上げも、実際に使う企業にとって大事な確認事項になります。
私は、Carbonを「性能の頂点」というより、「強い力をどう渡すかを試す段階の一歩」として見ています。事実が出そろうまで、数字の1点差に一喜一憂せず、公開の範囲と第三者の検証を静かに見ていくのがよいでしょう。
参考サイトまとめ
- Google:Introducing Gemini 4 Carbonhttps://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/
- Google DeepMind:Fairwind Programhttps://deepmind.google/fairwind-program/
- Google DeepMind:Gemini 4 Carbon 評価手法https://deepmind.google/models/evals-methodology/gemini-4-carbon
- VentureBeat:Google unveils Gemini 4 Carbon, retaking the world’s no. 1 spot on updated, harder benchmarkshttps://venturebeat.com/technology/google-unveils-gemini-4-carbon-retaking-the-worlds-no-1-spot-on-updated-harder-benchmarks-but-access-is-limited
- WDC News:Google announces Gemini 4 Carbon, its new frontier AI modelhttps://wdcnews6.com/google-announces-gemini-4-carbon-its-new-frontier-ai-model/

コメント