こんにちは!AIフル装備 powered by みらいラボのモモです。
2026年10月29日、フランスのAI企業Mistral AIが、最上位モデル「Mistral Large 4」の重みを公開しました。愛称は「Le Chonk」で、総パラメータ数は1兆、1回の処理で実際に動くのは520億という大型のモデルです。
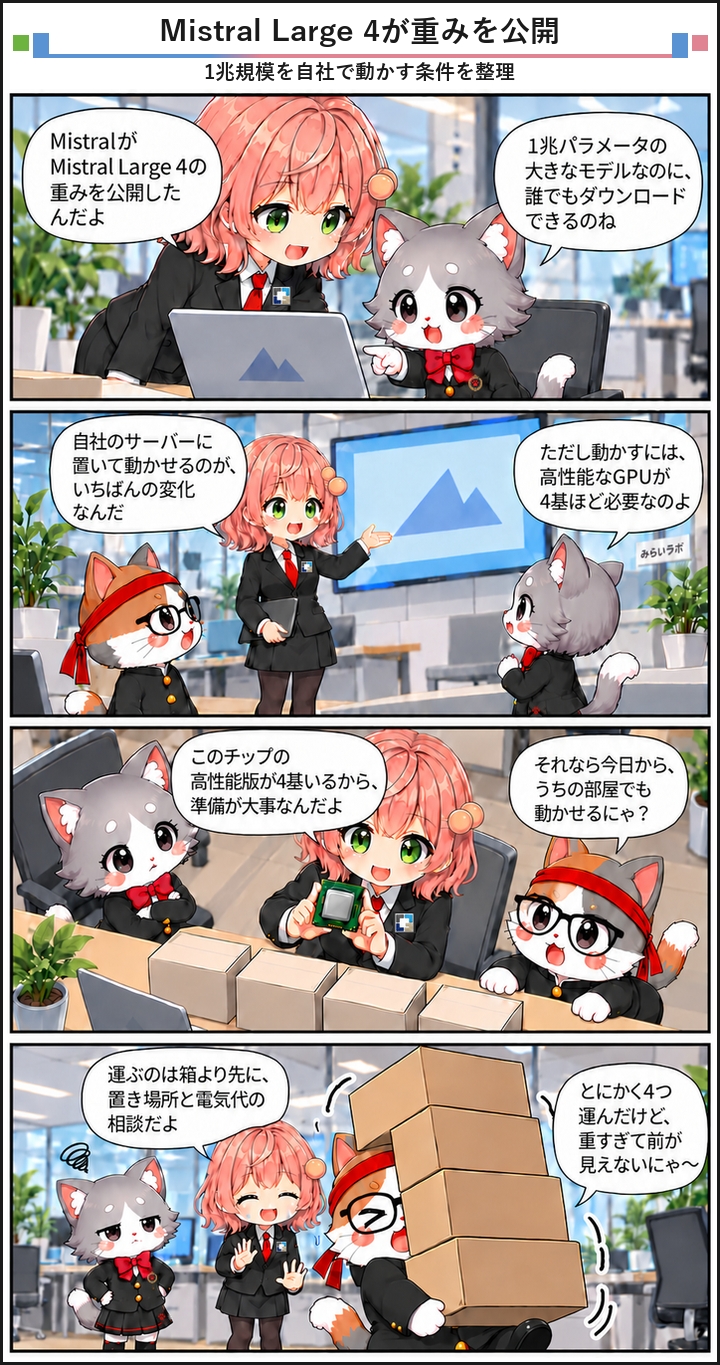
今月初めにプレビューとして登場したモデルが、約3週間の追加学習を経て、誰でもダウンロードできる形になりました。Hugging Faceで重みが配られ、自社のサーバーに置いて動かせるようになったことが、今回の大きな変化です。
同社が前面に出しているのは、コーディング能力とサイバー防御の強化です。ベンチマークの数字では、中国発のオープンモデルGLM-5.3と並ぶ水準を、少ないトークン使用量で出したと説明しています。
この記事では、何が公開されたのか、プレビューから何が変わったのか、競合と比べてどこに位置するのかを順に整理します。あわせて、ライセンスの条件や安全面の課題など、導入を考える前に確認したい点も取り上げます。

今回の公開内容とこれまでの流れ
最近のAI業界では、性能の高いモデルほどクラウド経由でしか使えない傾向がありました。OpenAIやAnthropicの最上位モデルは、企業のサーバーに置いて使うことができず、提供元のAPIを通す形が基本です。
一方で、中国発のGLMやKimi、DeepSeekといったオープンウェイトのモデルが、コーディング分野で存在感を高めてきました。重みが公開されたモデルは、自社環境で動かせて、用途に合わせて調整もできるため、企業の関心を集めています。
Mistralはこの流れの中で、欧州で学習した大型モデルの重みを公開する立場を取りました。CEOのArthur Menschさんは、最先端のAIが一部の主体に集中しないために、オープンソースは欠かせないと述べています。
プレビューから公開までの3週間
Mistral Large 4は、今月初め、パブリックプレビューとして先に公開されていました。その後の約3週間、顧客からのフィードバックを使った強化学習を重ねて、今回の公開版に仕上げています。
学習の成果は数字にも出ています。エージェント型のコーディングを測るTerminal-Bench 4.0のスコアは、プレビュー時点の28%から41%へ、13ポイント上がりました。
プレビュー版と公開版の主な違い
| 項目 | プレビュー版 | 公開版 |
|---|---|---|
| Terminal-Bench 4.0 | 28% | 41%(出力トークンは30%減) |
| B3 Agent Security(攻撃への耐性) | 93.3% | 97.1% |
| FinWorkBench(Finch) | 67.4% | 73.3% |
| 推論モード | None(公開版ではLowに置き換え) | Low・Medium・High の3段階(既定は High) |
この表のとおり、コーディングだけでなく、安全面や金融系の業務タスクでも数値が伸びました。推論の深さを3段階から選べるようになり、以前の「None」は「Low」に置き換わっています。
モデルの仕様と入手方法
モデルの中身は、指示への応答と推論を1つにまとめたハイブリッド型のMoE(専門家混合)です。テキストと画像を読み込み、テキストとコードを出力します。
160以上の言語に対応し、学習は欧州のインフラでゼロから行ったと説明されています。MoEは、巨大なモデルの一部だけを呼び出して動かす仕組みで、総量に比べて計算の負担を抑えられるのが特長です。
学習には、欧州のデータセンターに置かれたNVIDIAのGrace Blackwell GPU、約3,800基が使われました。TNWの報道によると、量子化した版はNVIDIA B200またはB300を4基そろえれば動かせます。
入手先はHugging Faceのリポジトリ「mistralai/Mistral-Large-4-1T-A52B」で、vLLMやSGLangを使って自社環境に展開できます。APIやMistral Studioのほか、OpenRouter、NVIDIAのホスト型エンドポイント、Microsoft Foundryでも使えると、同社の発表ページに書かれています。
- Hugging Faceのリポジトリから重みをダウンロードする
- vLLMまたはSGLangで、自社のGPUサーバーに展開する
- 推論モードをLow・Medium・Highから選び、タスクに合わせて深さを調整する
- 自社データでの調整が必要なら、Mistralの Forge を使う
性能を数字で比べる
Mistralは今回、コーディングとサイバーの2分野で、競合のオープンモデルと並ぶ、または上回る数字を示しています。ただし、これらの数値は主にMistral自身の発表にもとづくもので、第三者による独立した検証はまだ十分に出そろっていません。
比較の相手として挙げられているのは、中国発のGLM-5.3、Kimi K3、DeepSeek V4.1 Flashです。OpenAIやAnthropicのクローズドなモデルとは、重みを自由に使えるかどうかという前提が違います。
数字を読むときは、どのベンチマークで、どの相手と比べているかを分けて見ることが大切です。得意な分野と、まだ先行されている分野の両方を見ておくと、導入の判断がしやすくなります。
コーディング分野の位置づけ
Terminal-Bench 4.0では、Mistral Large 4が41%で、GLM-5.3の40%、DeepSeek V4.1 Flashの31%、Kimi K3の21%を上回りました。僅差ではあるものの、同社はコーディングエージェント向けのオープンモデルとして最良だと位置づけています。
Artificial AnalysisのCoding Agent Indexでは48%で、GLM-5.3と実質的に並びました。タスクあたりのトークン使用量は平均で47%少ないとされ、同じ仕事を安く回せる点が強みになります。
主なベンチマークの比較
| ベンチマーク | Mistral Large 4 | 主な比較対象 |
|---|---|---|
| Terminal-Bench 4.0 | 41% | GLM-5.3 は40%、DeepSeek V4.1 Flash は31%、Kimi K3 は21% |
| CyberGym-E2E | 79% | MiMo-V2.6-Pro は79%、DeepSeek V4.1 Flash は76% |
| BrowseComp | 84.5% | Kimi K3 は91.2%、DeepSeek V4.1 Flash は83.4% |
| FinWorkBench(Finch) | 73.3% | Kimi K3 は77.3%でオープンモデルの首位 |
表を見ると、すべての分野で首位というわけではありません。ウェブ上で調べ物をするBrowseCompではKimi K3が上、金融系のFinchでもKimi K3が上で、Mistral Large 4はオープンモデルの2位にあたります。
人間による好みの比較でも、傾向は似ています。コーディングの出力を人が選ぶSurge Codeの評価では、GLM-5.3に対しておよそ64%対36%で好まれた一方、Claude Opus 5.5との比較では22%対78%で負けており、クローズドな最上位モデルとはまだ差があります。
CognitionのFrontierCode 2.0では19.7%を記録しました。重みが公開されたモデルとしては高い値ですが、この指標はリポジトリの管理者がそのまま取り込むかを見るコード品質の評価で、実際の業務での使い勝手とは別に見る必要があります。
コーディングの現場にとっての意味は、出力トークンの少なさにあります。Terminal-Bench 4.0では出力トークンがプレビュー版より30%減ったと説明されており、同じ作業に支払う費用や待ち時間の短縮につながります。
サイバー分野の位置づけ
サイバー分野では、C/C++のメモリ安全性のバグを見つけ、再現し、修正まで行うCyberGym-E2Eで79%を記録しました。MiMo-V2.6-Proと並び、DeepSeek V4.1 Flashの76%を上回っています。
AA Cyber Indexでは51%で、脆弱性の発見、再現と検証、既存の機能を壊さない修正という流れを評価した数値です。
攻撃に対する強さを測るB3 Agent Securityは97.1%で、有害なサイバー要求を断る率は平均96.6%と説明されています。この拒否率は、JailbreakBench、StrongREJECT、AgentHarmのサイバー関連の問いで測ったものです。
これらの数字を読むときは、拒否率が高いほど良いとは限らない点にも注意が必要です。断りすぎると、正当な防御の作業まで止まってしまうためで、Mistralは防御目的のタスクを不必要な拒否なしに処理できると説明しています。
実際に自社の環境で使うなら、公開されたベンチマークの値をそのまま信じるのではなく、手元のコードや脆弱性の事例で試して、見つける数と誤検知の割合を確かめるのが確実です。重みが手に入る今回のモデルは、そうした検証がやりやすい形になっています。
サイバー防御とデータ主権という売り込み
今回の発表で、Mistralがとくに強調したのは、サイバー防御の用途です。企業の声明では、増える脅威の中でMistral Large 4(以下ML4)が、主権を保てる最先端のサイバー防御能力を届けると説明しています。
具体的には、コードやIT基盤の全体にわたって、脅威の検知、分析、対応を行う使い方を想定しています。重みを自社に置けるため、機密性の高いデータを外部のクラウドに出さずに処理できる点が、官公庁や金融機関には響きやすい部分です。
実際の評価には、Booz Allen、Cisco、Cloudflare、CrowdStrike、Elastic、ENISA、Fortinet、Orange Cyberdefense、Rubrik、Zscalerといった企業や機関が、評価やコメントに協力したと、同社は説明しています。
防御担当者が受ける利点
サイバー防御の現場では、ログやコードの量が膨大で、人手の確認が追いつかないことが課題です。大型モデルが脅威の分析や修正案の作成を手伝えれば、担当者は判断が必要な部分に時間を使えるようになります。
科学担当バイスプレジデントのPierre Stockさんは、重みが公開されたモデルなら、定義上アクセスを止められないと説明しました。クラウドのAPIは、提供元の都合で突然使えなくなる可能性がありますが、手元の重みならその心配がありません。
さらに同氏は、攻撃者が同じ技術を使える以上、防御側にも同等の能力を早く広く行き渡らせるべきだという立場を示しました。防御を優先して早く配るという考え方です。
悪用のリスクとガードレール
一方で、重みを公開することにはリスクもあります。Mistralは、プレビュー公開以降に実際のトラフィックを監視したところ、ブラックボックス型の攻撃は拒否できていたものの、実際の攻撃に悪用される可能性があるため、ガードレールを修正中だと明かしています。
また、ペネトレーションテストや脆弱性評価、レッドチーム向けの特別な版を、Orange Cyberdefenseなどの設計パートナーに限ってプレビュー提供しています。審査と契約上の安全策を設け、テストは所有する、または明示的に許可されたシステムに限る運用です。
- 性能の数値は主にMistral自身の発表で、独立した検証はこれから
- 重みの公開は、攻撃者にも使える状態になることを意味する
- プレビュー期間中の監視を受けて、同社はガードレールを修正している最中
- 自社で動かす場合は、GPUの確保や運用の体制を自分で用意する必要がある
導入前に確認したい条件と今後の注目点
オープンウェイトと聞くと、何でも自由に使えると考えがちですが、条件には注意が必要です。今回のモデルは、重みが公開されていても、使い方によっては追加の契約が必要になります。
価格についても、自社で動かす場合と、Mistralやパートナーのサービスを通す場合で、考え方が変わります。自社運用はライセンス料が不要な代わりに、GPUの費用と運用の手間が加わります。
また、今回の公開は、Mistralが3年間で約60億ドルを調達して実現した取り組みだという点も、背景として押さえておきたいところです。Menschさんは、他社が数千億ドル規模の資金を集めていることとの対比を語っています。
ライセンスと価格の条件
ライセンスは「Mistral Ecosystem Open-Weight license」で、修正を加えたMITライセンスと説明されています。使用、改変、ファインチューニング、商用利用は自由に行えます。
例外として、モデルをサービスとして他社に提供する事業者(Model-as-a-Service)は、商用利用にあたってMistralから別途ライセンスを得る必要があります。社内利用なら問題になりにくく、モデルを組み込んだ有料のAPIを売る場合は確認が要ります。
Mistralの発表ページによると、APIの価格は入力が100万トークンあたり0.70ドル、キャッシュ入力が0.07ドル、出力が2.10ドルです。なお、報道によってはAPI価格に触れていないものもあり、導入時は公式の最新の料金表で確かめてください。
自社運用を考える読者にとっては、必要な計算資源の見積もりも大切です。量子化版でもB200またはB300が4基という規模なので、小さな会社がすぐ試せる水準ではなく、クラウド事業者やパートナー経由の利用が現実的な入口になります。
運用面では、推論モードの選び方も費用を左右します。Mistralは推論の深さをLow、Medium、Highから選べるとしており、簡単な作業は浅く、難しい作業は深く回すことで、トークンの消費をタスクごとに管理できます。
導入の入口としては、Mistral Studioでの試用やVibe Code、カスタマイズ用のForgeが用意されています。いきなり自社のGPUに載せる前に、API経由で自社の課題に合うかを確かめてから、重みの運用に進む順序が無理のない進め方です。
第三者の評価という点では、Artificial Analysisのように複数のモデルを同じ条件で比べる機関の更新が参考になります。Mistralの示した48%という指数が、他社モデルの更新後も同じ位置にあるかを見ておくと、優位性が一時的かどうかが分かります。
また、今回の発表では、重みの公開とAPI価格の両方が示されました。自社運用とAPI利用のどちらが割に合うかを、トークン量の見込みから試算できる材料が出ました。
これから注目したい点
1つ目は、独立機関による検証です。Artificial Analysisの指標はすでに一部使われていますが、他の評価者が同じ条件で再現できるかが、数字の信頼度を左右します。
2つ目は、ガードレールの修正の行方です。重みを公開した後に悪用が見つかった場合の対応は、オープンウェイトの安全性を考えるうえで前例になります。
3つ目は、小型版の登場です。TNWによると、ノートPCで動くものを含む、蒸留した小型のモデルを今後数か月以内に出す予定ですが、時期は確定していません。
また、同社は高い推論モードで効率が約50%上がったとも説明しています。高性能と低コストの両立が実際の運用でどこまで続くかは、利用者の報告が増えてから見えてくるでしょう。
まとめ
Mistral Large 4は、1兆パラメータ、アクティブ520億のMoEモデルで、2026年10月29日に重みが公開されました。今月初めのプレビューから約3週間の強化学習を経て、Terminal-Bench 4.0が28%から41%に上がり、コーディングとサイバーで競合のオープンモデルと並ぶ数字を示しています。
このニュースが重要なのは、最先端に近い性能のモデルを、自社の環境で動かせる選択肢が欧州から出てきたからです。クラウドの提供元に依存せず、機密データを手元に置いたまま使えることは、とくに防御の現場で意味を持ちます。
今後の注目点は、第三者による検証、公開後のガードレールの修正、そして小型版の登場時期です。ライセンスにはサービス提供者向けの例外があるため、導入を考える企業は、自社の使い方がその対象にならないかも確認する必要があります。
私はこのニュースを、性能の競争というより、AIをどこで動かすかの選択肢が増えた出来事として見ています。数字の多くがまだ発表者自身のものである点は割り引きつつ、自社の用途で動かして確かめられるようになったことを、前向きに評価したいです。
読者のみなさんは、独立した検証結果とガードレールの更新を、今後の判断材料として見ていくとよいでしょう。
参考サイトまとめ
- Mistral Large 4 (Le Chonk) is now open weight – Mistral AIhttps://mistral.ai/news/mistral-large-4-oss/
- Mistral releases weights for its trillion-parameter AI model, targeting cybersecurity – TechCrunchhttps://techcrunch.com/2026/10/29/mistral-releases-weights-for-its-trillion-parameter-ai-model-targeting-cybersecurity/
- Mistral releases open weights for its 1 trillion-parameter Large 4 model – The Next Webhttps://thenextweb.com/news/mistral-large-4-open-weights-release
- Mistral releases open weights for Mistral Large 4 – SiliconANGLEhttps://siliconangle.com/2026/10/29/mistral-releases-open-weights-for-mistral-large-4-providing-sovereign-control-for-the-companys-le-chonk-ai-model/

コメント